
Radio potrafi zaskoczyć już przy pierwszym przełączeniu źródła dźwięku. Utwór odtwarzany z własnego pliku ma ciche zwrotki i mocny refren, tymczasem ta sama piosenka w stacji radiowej brzmi bardziej równo, bliżej i często pozornie głośniej. Po niej wchodzi prowadzący, reklama albo serwis informacyjny, a słuchacz zwykle nie musi gwałtownie sięgać do pokrętła.
Nie jest to przypadek ani wyłącznie efekt regulacji głośności w studiu. Zanim program trafi do nadajnika FM, multipleksu DAB+ albo internetowego strumienia, przechodzi przez łańcuch urządzeń i algorytmów kontrolujących poziom, dynamikę oraz najwyższe szczyty sygnału. Ich zadaniem jest utrzymanie czytelności i technicznego bezpieczeństwa transmisji, ale sposób ustawienia procesora wpływa też na charakter brzmienia całej stacji.
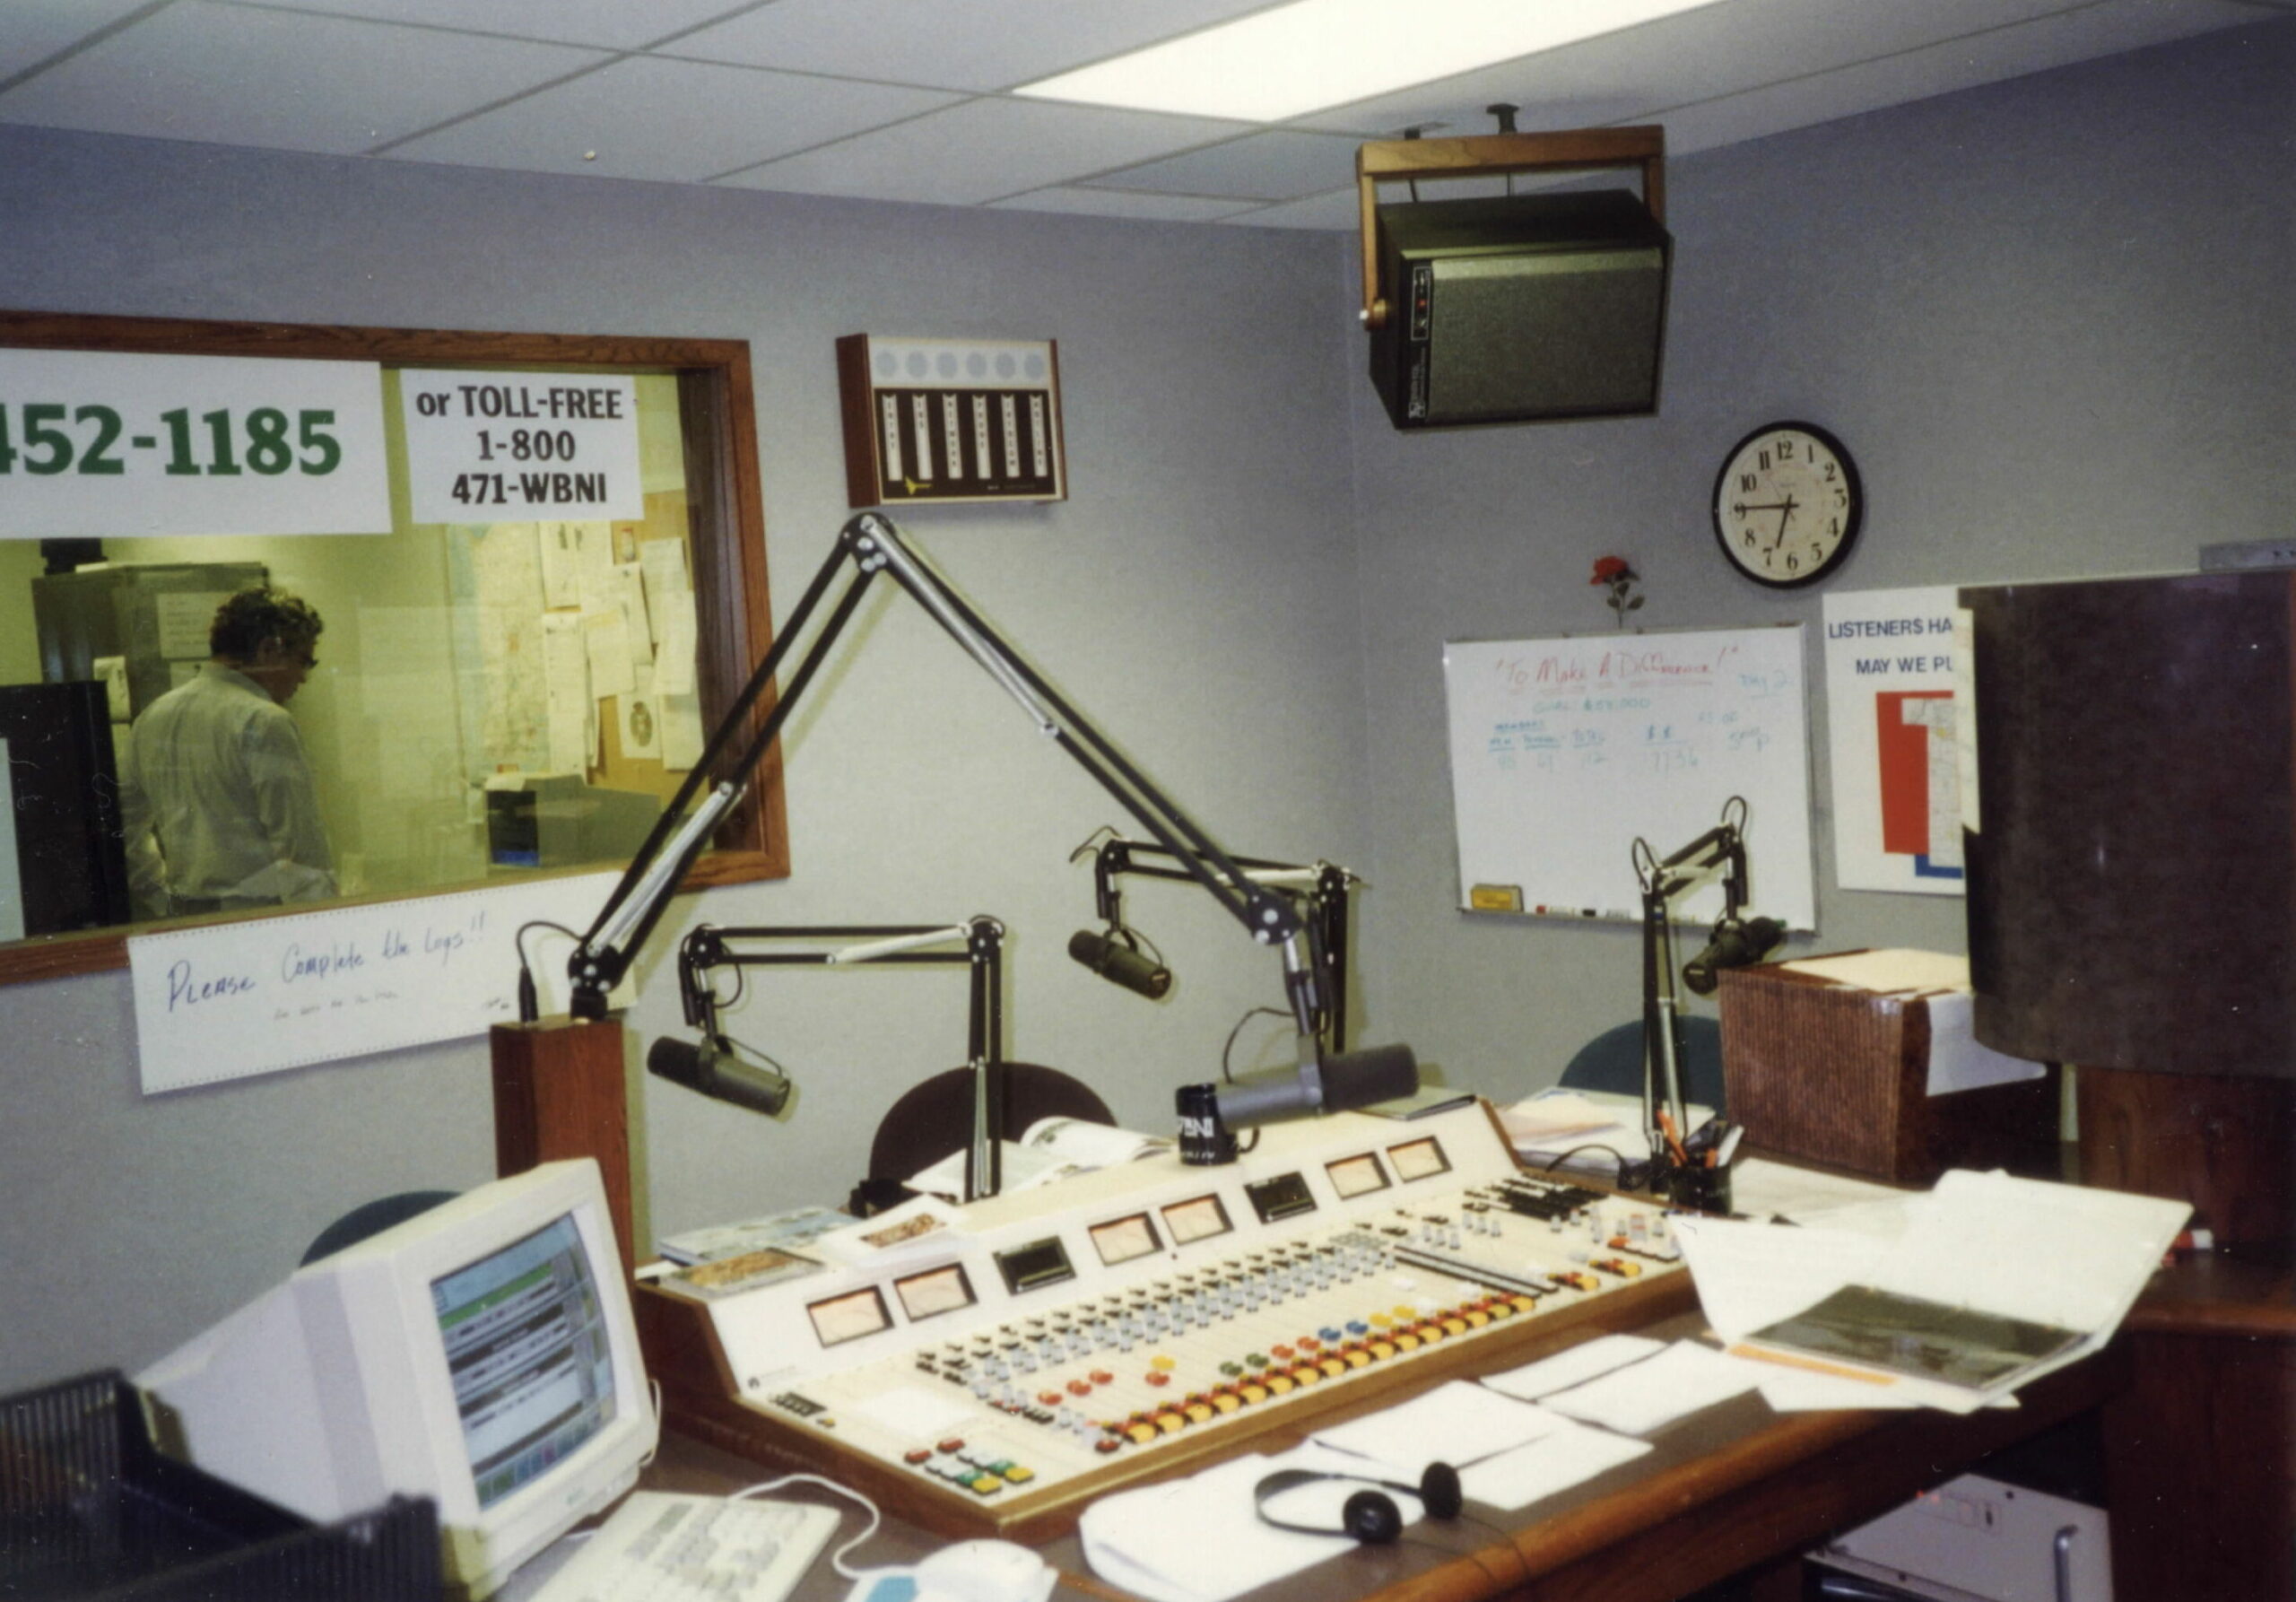

Głośność nie jest jedną liczbą
W rozmowach o dźwięku łatwo pomieszać trzy różne pojęcia. Poziom szczytowy mówi, jak blisko sygnał znalazł się maksymalnej dopuszczalnej wartości. Średni poziom opisuje energię w dłuższym czasie, a głośność jest wrażeniem słuchowym zależnym również od częstotliwości, czasu trwania i charakteru materiału. Audio Engineering Society podkreśla, że głośność jest wielkością postrzeganą, a nie prostym odpowiednikiem wskazania miernika napięcia.
Dwa nagrania mogą mieć identyczny najwyższy szczyt, a mimo to jedno wyda się znacznie głośniejsze. Jeśli pierwszy utwór ma dużo miejsca między cichymi a głośnymi fragmentami, jego przeciętny poziom będzie niższy. Drugi może przez większość czasu znajdować się blisko maksimum i dlatego zabrzmi donośniej, chociaż żaden pojedynczy impuls nie przekroczy poziomu pierwszego.
Po co rozgłośni procesor dźwięku?
Program radiowy składa się z materiałów o bardzo różnym charakterze. W ciągu kilku minut mogą pojawić się starsze nagranie, współczesny mocno zmasterowany utwór, spokojny głos reportera, telefon słuchacza i krótki dżingiel. Bez automatycznej kontroli jedne elementy byłyby za ciche, inne za głośne, a przypadkowy impuls mógłby przekroczyć dopuszczalny poziom modulacji.
Procesor emisyjny porządkuje te różnice. Nie zastępuje realizatora ani dobrego przygotowania materiałów, ale tworzy ostatnią linię kontroli przed emisją. Dzięki niemu mowa pozostaje zrozumiała w samochodzie, muzyka nie znika pod szumem otoczenia, a nadajnik otrzymuje sygnał mieszczący się w wymaganych granicach.
Nowoczesne urządzenie nie jest po prostu jednym kompresorem. Przykładowa architektura opisana przez producenta Telos Alliance obejmuje szerokopasmową automatykę wzmocnienia, wielopasmowe układy AGC i kompresory, limitery, korekcję, obróbkę basu oraz końcowy układ kontrolujący szczyty. Poszczególne stacje mogą używać innych urządzeń, lecz ogólna logika łańcucha jest podobna.
Pierwszy etap: powolne wyrównywanie poziomu
Na początku często pracuje AGC, czyli automatyczna regulacja wzmocnienia. Działa stosunkowo wolno. Gdy kolejne źródło jest wyraźnie cichsze, AGC stopniowo je podnosi; gdy materiał przychodzi zbyt mocny, obniża wzmocnienie. Chodzi o doprowadzenie sygnału do wygodnego zakresu pracy następnych stopni, a nie o spłaszczenie każdego uderzenia perkusji.
Zbyt szybka lub zbyt głęboka automatyka byłaby łatwa do usłyszenia. Po cichym fragmencie tło nagle wysuwałoby się do przodu, a po mocnym dźwięku całość na chwilę zapadałaby się. Takie „pompowanie” jest jednym z klasycznych skutków źle ustawionej obróbki. Dlatego czasy reakcji dobiera się do programu, a profesjonalne procesory analizują sygnał w sposób zależny od jego przebiegu.
Dlaczego kompresja bywa wielopasmowa?
Zwykły kompresor ścisza cały sygnał, gdy przekroczy on ustalony próg. Jeżeli mocne uderzenie basu uruchomi redukcję, razem z nim może na moment przycichnąć głos i góra pasma. Procesor wielopasmowy najpierw dzieli dźwięk na kilka zakresów częstotliwości, a potem kontroluje je częściowo niezależnie.
Dzięki temu niski bas może zostać uspokojony bez równie mocnego ściszania środka, w którym znajduje się większość informacji ważnej dla zrozumiałości mowy. Można też utrzymać bardziej stałą równowagę tonalną pomiędzy nagraniami pochodzącymi z różnych epok. Opis procesora Orban OPTIMOD wymienia między innymi automatykę wzmocnienia, korekcję, kompresję wielopasmową, ograniczanie szczytów i kodowanie stereo jako kolejne elementy toru emisyjnego FM.
Ta technika ma jednak cenę. Ustawiona delikatnie może jedynie uporządkować program. Ustawiona agresywnie zmniejsza kontrast między cichymi i głośnymi momentami, osłabia naturalne uderzenie instrumentów i po dłuższym słuchaniu może męczyć. Nie istnieje jeden idealny profil dla stacji informacyjnej, muzyki klasycznej i energicznego programu rozrywkowego.
Limiter i clipper pilnują granicy
Kompresor kontroluje dynamikę, ale pozostawia krótkie impulsy. Dlatego bliżej wyjścia pracuje limiter, który reaguje na szczyty i nie pozwala im przekroczyć ustalonego poziomu. W torze FM spotyka się również clipper, czyli układ bardzo precyzyjnie ograniczający najwyższe fragmenty przebiegu. Służy on nie tylko uzyskaniu większej odczuwalnej głośności, lecz przede wszystkim utrzymaniu modulacji w bezpiecznych granicach.
Im częściej i mocniej taki układ musi działać, tym większe ryzyko zniekształceń. Dobry procesor rozkłada więc pracę pomiędzy kilka łagodniejszych etapów, zamiast pozostawiać całe zadanie brutalnemu cięciu na końcu. Producenci wykorzystują analizę wyprzedzającą, sterowanie zależne od programu i ograniczanie wielopasmowe, aby zachować możliwie czysty dźwięk.
FM ma własny problem z wysokimi tonami
Analogowa transmisja FM wykorzystuje preemfazę: przed nadaniem wysokie częstotliwości są wzmacniane, a odbiornik wykonuje odwrotną deemfazę. Taki zabieg poprawia stosunek sygnału do szumu w górnej części pasma. W Europie stosuje się charakterystykę 50 mikrosekund, a w części innych regionów 75 mikrosekund.
Wzmocnienie wysokich tonów oznacza jednak, że sybilanty w mowie, talerze perkusji lub ostre impulsy mogą szybciej doprowadzić tor do granicy modulacji. Procesor FM musi przewidywać ten efekt i odpowiednio kontrolować materiał jeszcze przed nadajnikiem. Specyfikacje urządzeń Orban opisują osobne przetwarzanie z preemfazą 50 lub 75 mikrosekund oraz niezależny tor ograniczania szczytów dla emisji cyfrowej. To jedna z przyczyn, dla których dokładnie ten sam program może być obrabiany nieco inaczej dla FM, DAB+ i streamu.
Od miernika szczytów do pomiaru LUFS
Przez lata realizatorzy w dużej mierze pilnowali szczytów. Taki pomiar nie mówił jednak dobrze, jak głośny wyda się cały program. Międzynarodowe zalecenie ITU-R BS.1770 opisuje algorytm pomiaru głośności programu i rzeczywistego poziomu szczytowego. Na tej podstawie Europejska Unia Nadawców opracowała rodzinę zaleceń EBU R 128.
Podstawowe EBU R 128 zaleca normalizowanie programu do średniej głośności −23 LUFS i używanie dodatkowych informacji o zakresie głośności oraz maksymalnym poziomie true peak. Dla radia powstał osobny suplement EBU R 128 s3, uwzględniający specyfikę produkcji i dystrybucji radiowej.
Normalizacja głośności i agresywna kompresja nie są tym samym. Pierwsza ustawia cały materiał na wspólnym punkcie odniesienia, ale może zachować jego wewnętrzną dynamikę. Druga zmienia różnice pomiędzy cichymi i głośnymi fragmentami. Rozgłośnia może korzystać z obu metod: przygotowywać materiały według pomiaru LUFS, a następnie stosować łagodną obróbkę emisyjną dopasowaną do sposobu transmisji.
Dlaczego stacje nie brzmią identycznie?
Procesor jest również narzędziem kształtowania brzmienia. Jedna stacja wybiera dźwięk otwarty i dynamiczny, inna chce być gęsta, ciepła i bardzo obecna, a jeszcze inna stawia przede wszystkim na zrozumiałość głosu. Znaczenie mają format programu, typ muzyki, jakość materiałów, docelowe odbiorniki i warunki słuchania.
W samochodzie lub zatłoczonej kuchni mniejsza dynamika może być zaletą, bo ciche szczegóły nie giną pod hałasem. W spokojnym pokoju ten sam sposób przetwarzania może wydawać się płaski. Najlepszy kompromis nie polega więc na osiągnięciu największej możliwej głośności, lecz na zachowaniu czytelnego i rozpoznawalnego brzmienia bez niepotrzebnego zmęczenia słuchacza.
Co naprawdę słyszymy po naciśnięciu „play”?
Sygnał radiowy jest wynikiem wielu decyzji podjętych długo przed głośnikiem odbiornika. Poziomy zostały wyrównane, pasmo podzielone i kontrolowane, szczyty ograniczone, a tor przygotowany do wymagań konkretnej emisji. Dobrze ustawiony procesor pozostaje niemal niewidoczny: prowadzący brzmi wyraźnie, utwory nie zaskakują gwałtownymi skokami, a całość mieści się w technicznych granicach.
Gdy obróbki jest za dużo, zaczynamy słyszeć sam proces: znikającą dynamikę, pompowanie, ostrość albo zniekształcone impulsy. Radio nie brzmi więc „głośno” dzięki jednemu magicznemu pokrętłu. To rezultat całego łańcucha, w którym technika, psychoakustyka i pomysł stacji na własne brzmienie spotykają się tuż przed wysłaniem programu w eter.